2026年9月期、次世代検索適合性診断プラットフォーム「AIOGeoScan」におけるサイト診断セッション数は前月を上回る過去最多の449件(サイトマップ検出総URL数 233,175件)を記録し、詳細なセマンティック解析が完了した有効個別ページ診断データは3,828件(338ドメイン)に達しました。
生成AI検索環境下(Google AI Overviews、ChatGPT Search、Perplexity等)における実態を多角的に分析した結果、構造化データ(JSON-LD)未実装率は50.7%と前月(58.7%)から約8ポイントの改善を見せたものの、その内実はCMSテーマが出力する外枠のメタデータに極端に偏重しており、コンテンツ本体や発信者主体の意味論的定義が欠落する「浅い構造化データ(Shallow Schema)」の病理が浮き彫りとなりました。
さらに、AI検索エンジンが回答を合成する際の必須要件である「アンサーターゲット警告率」は86.2%へ上昇。執筆者の同定に不可欠な著者スキーマ(Person)未対応率は85.8%、更新日(dateModified)未定義率は70.1%に達しています。今月一定数の診断ログ(217件)が蓄積された医療・クリニック領域をケーススタディとして検証しても、高い信頼性が求められる領域においてなおE-E-A-T信頼性シグナルの機械検証不備が顕著な課題として認められます。
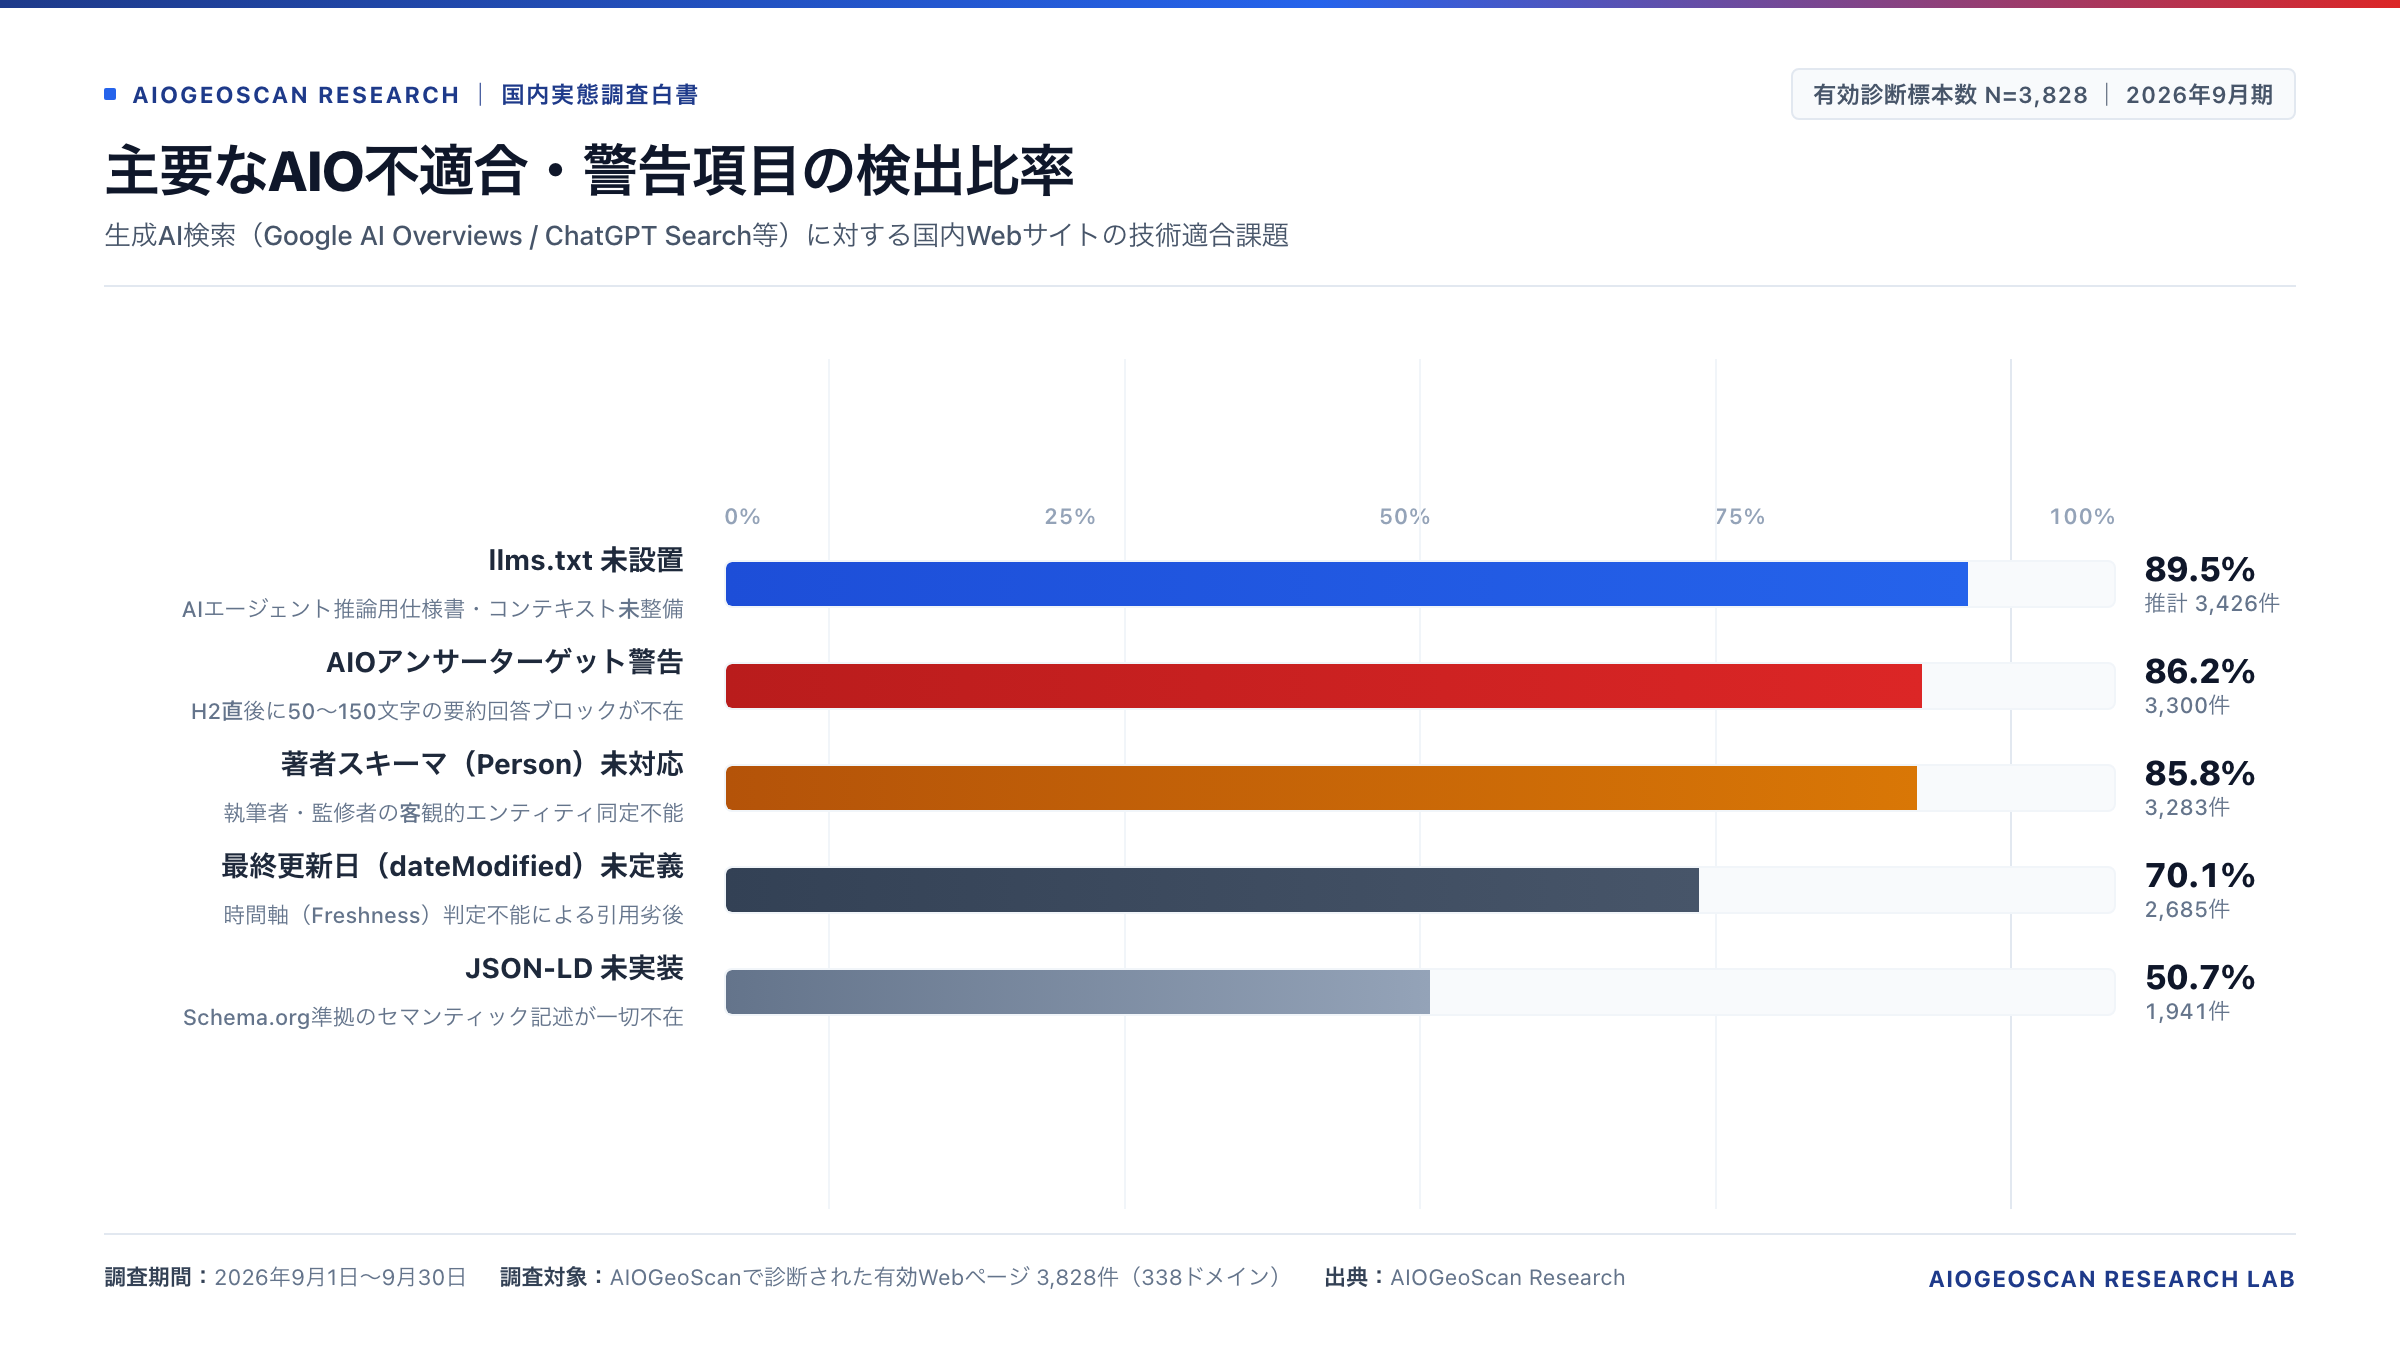
- アンサーターゲット不備率86.2%:Dense Retrievalとの情報純度の不整合
見出し(H2/H3)直下に50〜150文字の完結した結論要約を配置しないレイアウトが8割超を占有。RAGパイプラインのチャンキング処理において情報密度(Information Density)が希釈され、ColBERT等のパッセージリランキング段階で致命的なスコア減衰を招いています。 - 「浅い構造化データ」の蔓延とナレッジグラフ空洞化(未実装率 50.7%)
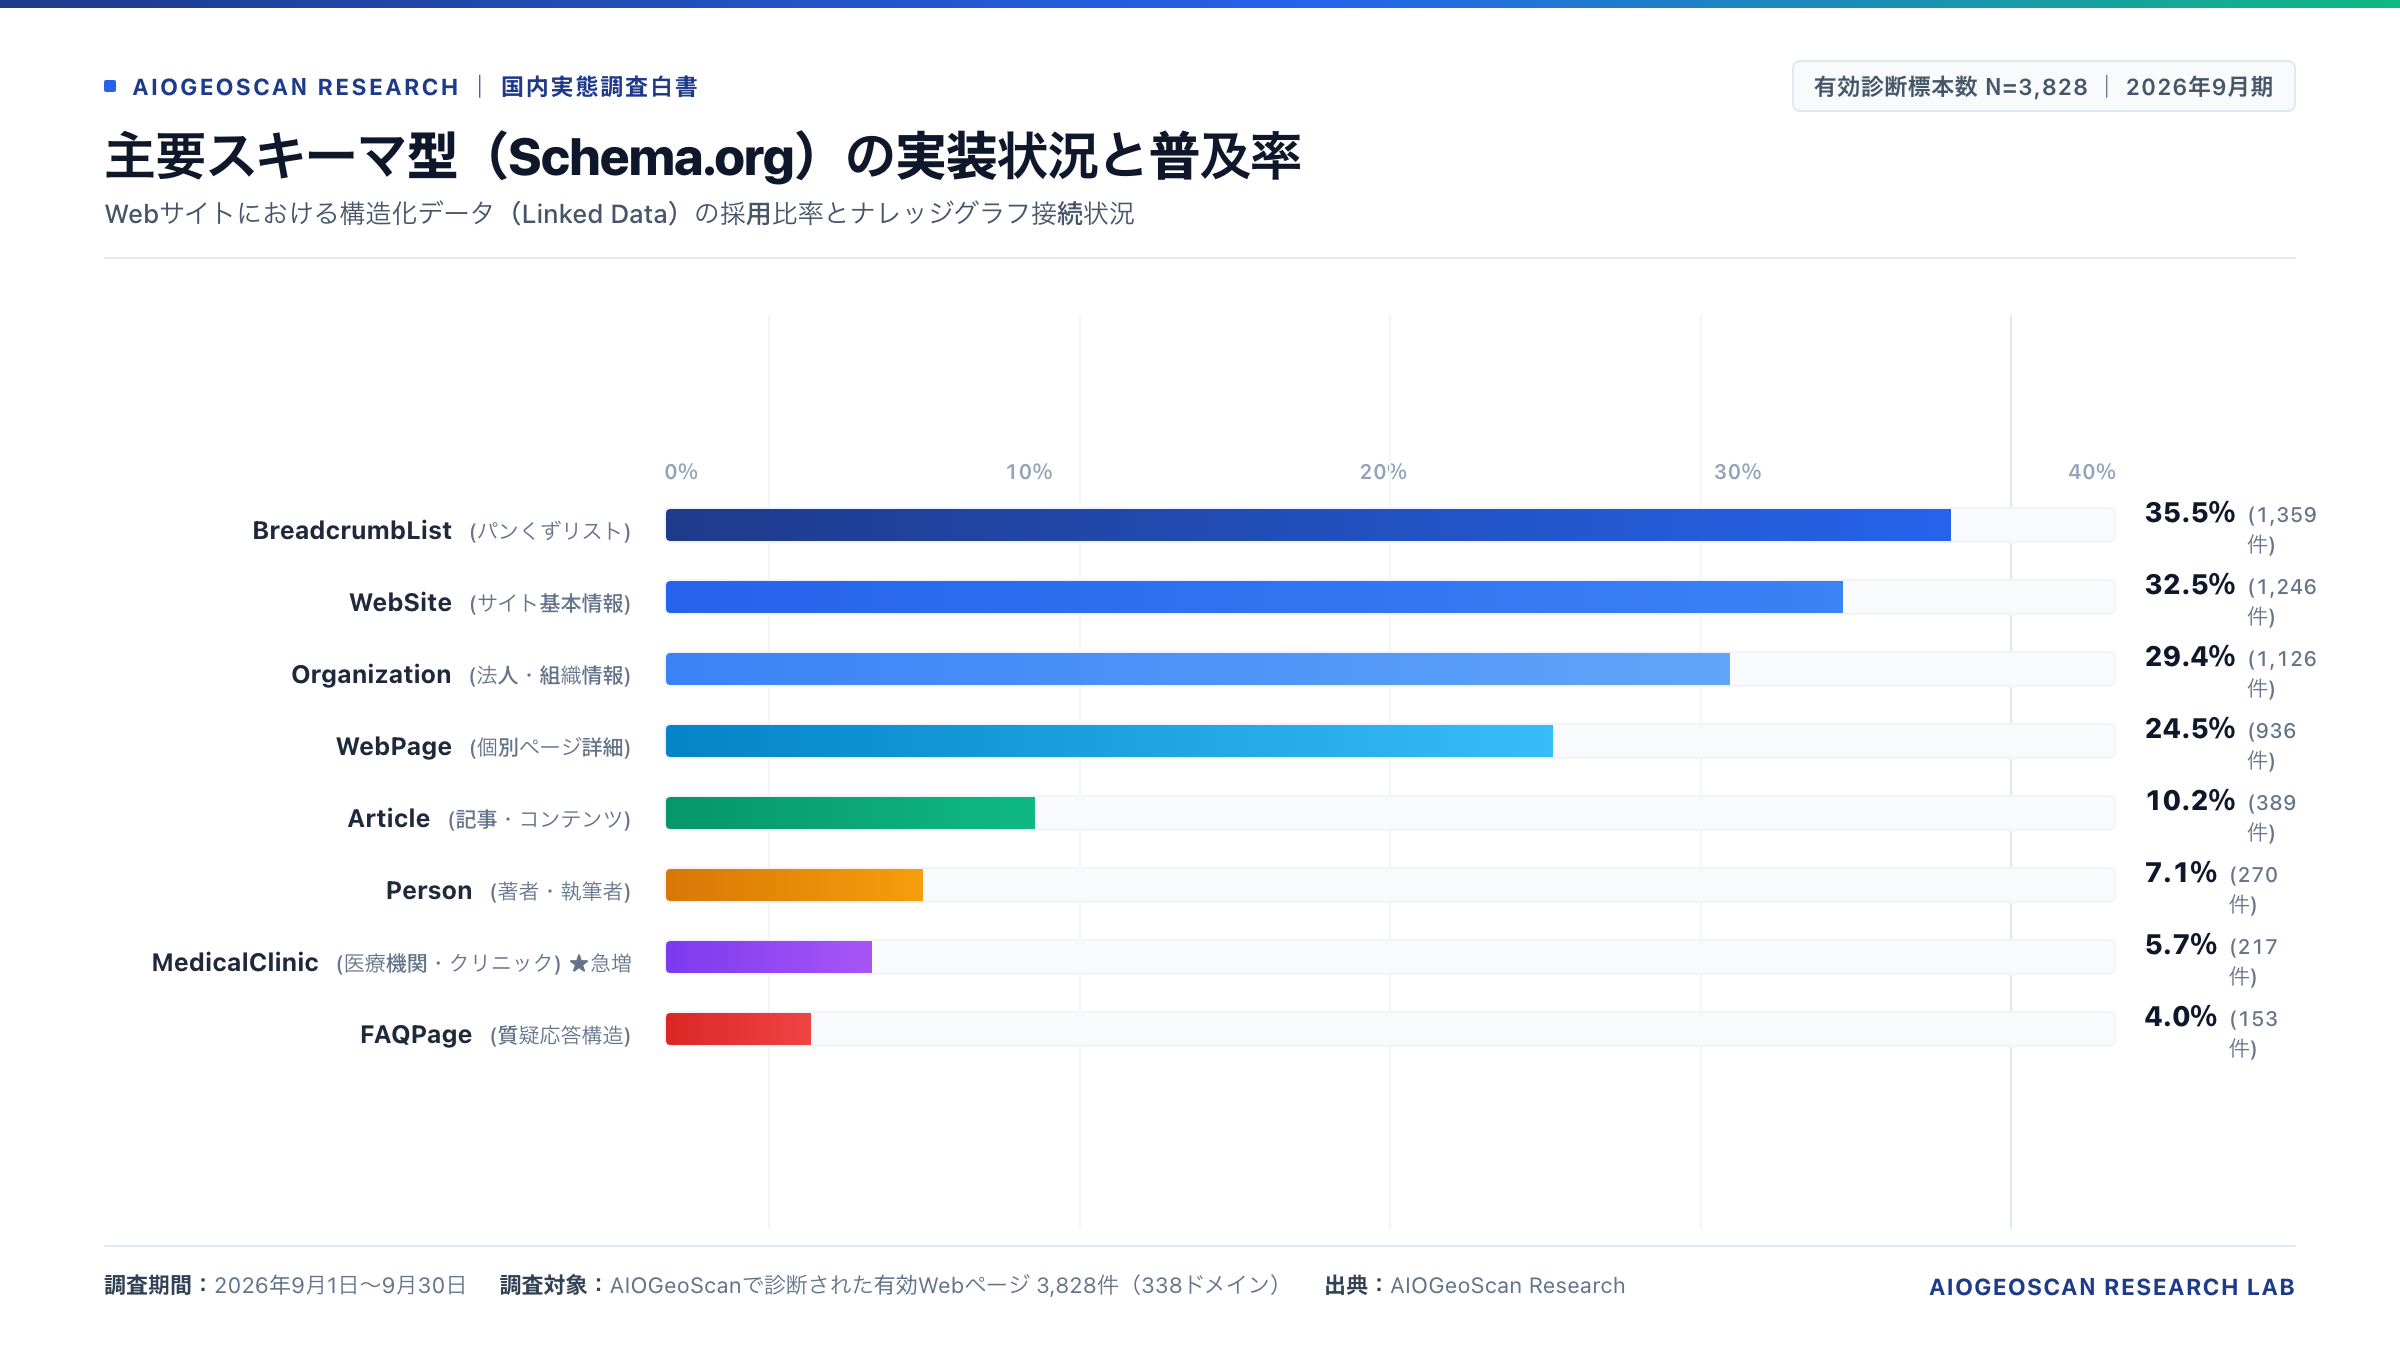
構造化データの未実装率は約8ポイント改善したものの、実装実態はパンくず(35.5%)やサイト基本情報(32.5%)などの自動出力に偏重。コンテンツ本体(Article 10.2%)や発信主体(Person 7.1%)、回答抽出(FAQPage 4.0%)が空洞化し、エンティティ曖昧性解消(Disambiguation)が機能していません。 - 【注目分野検証】医療(MedicalClinic 5.7%)に見るE-E-A-T機械検証の技術的課題
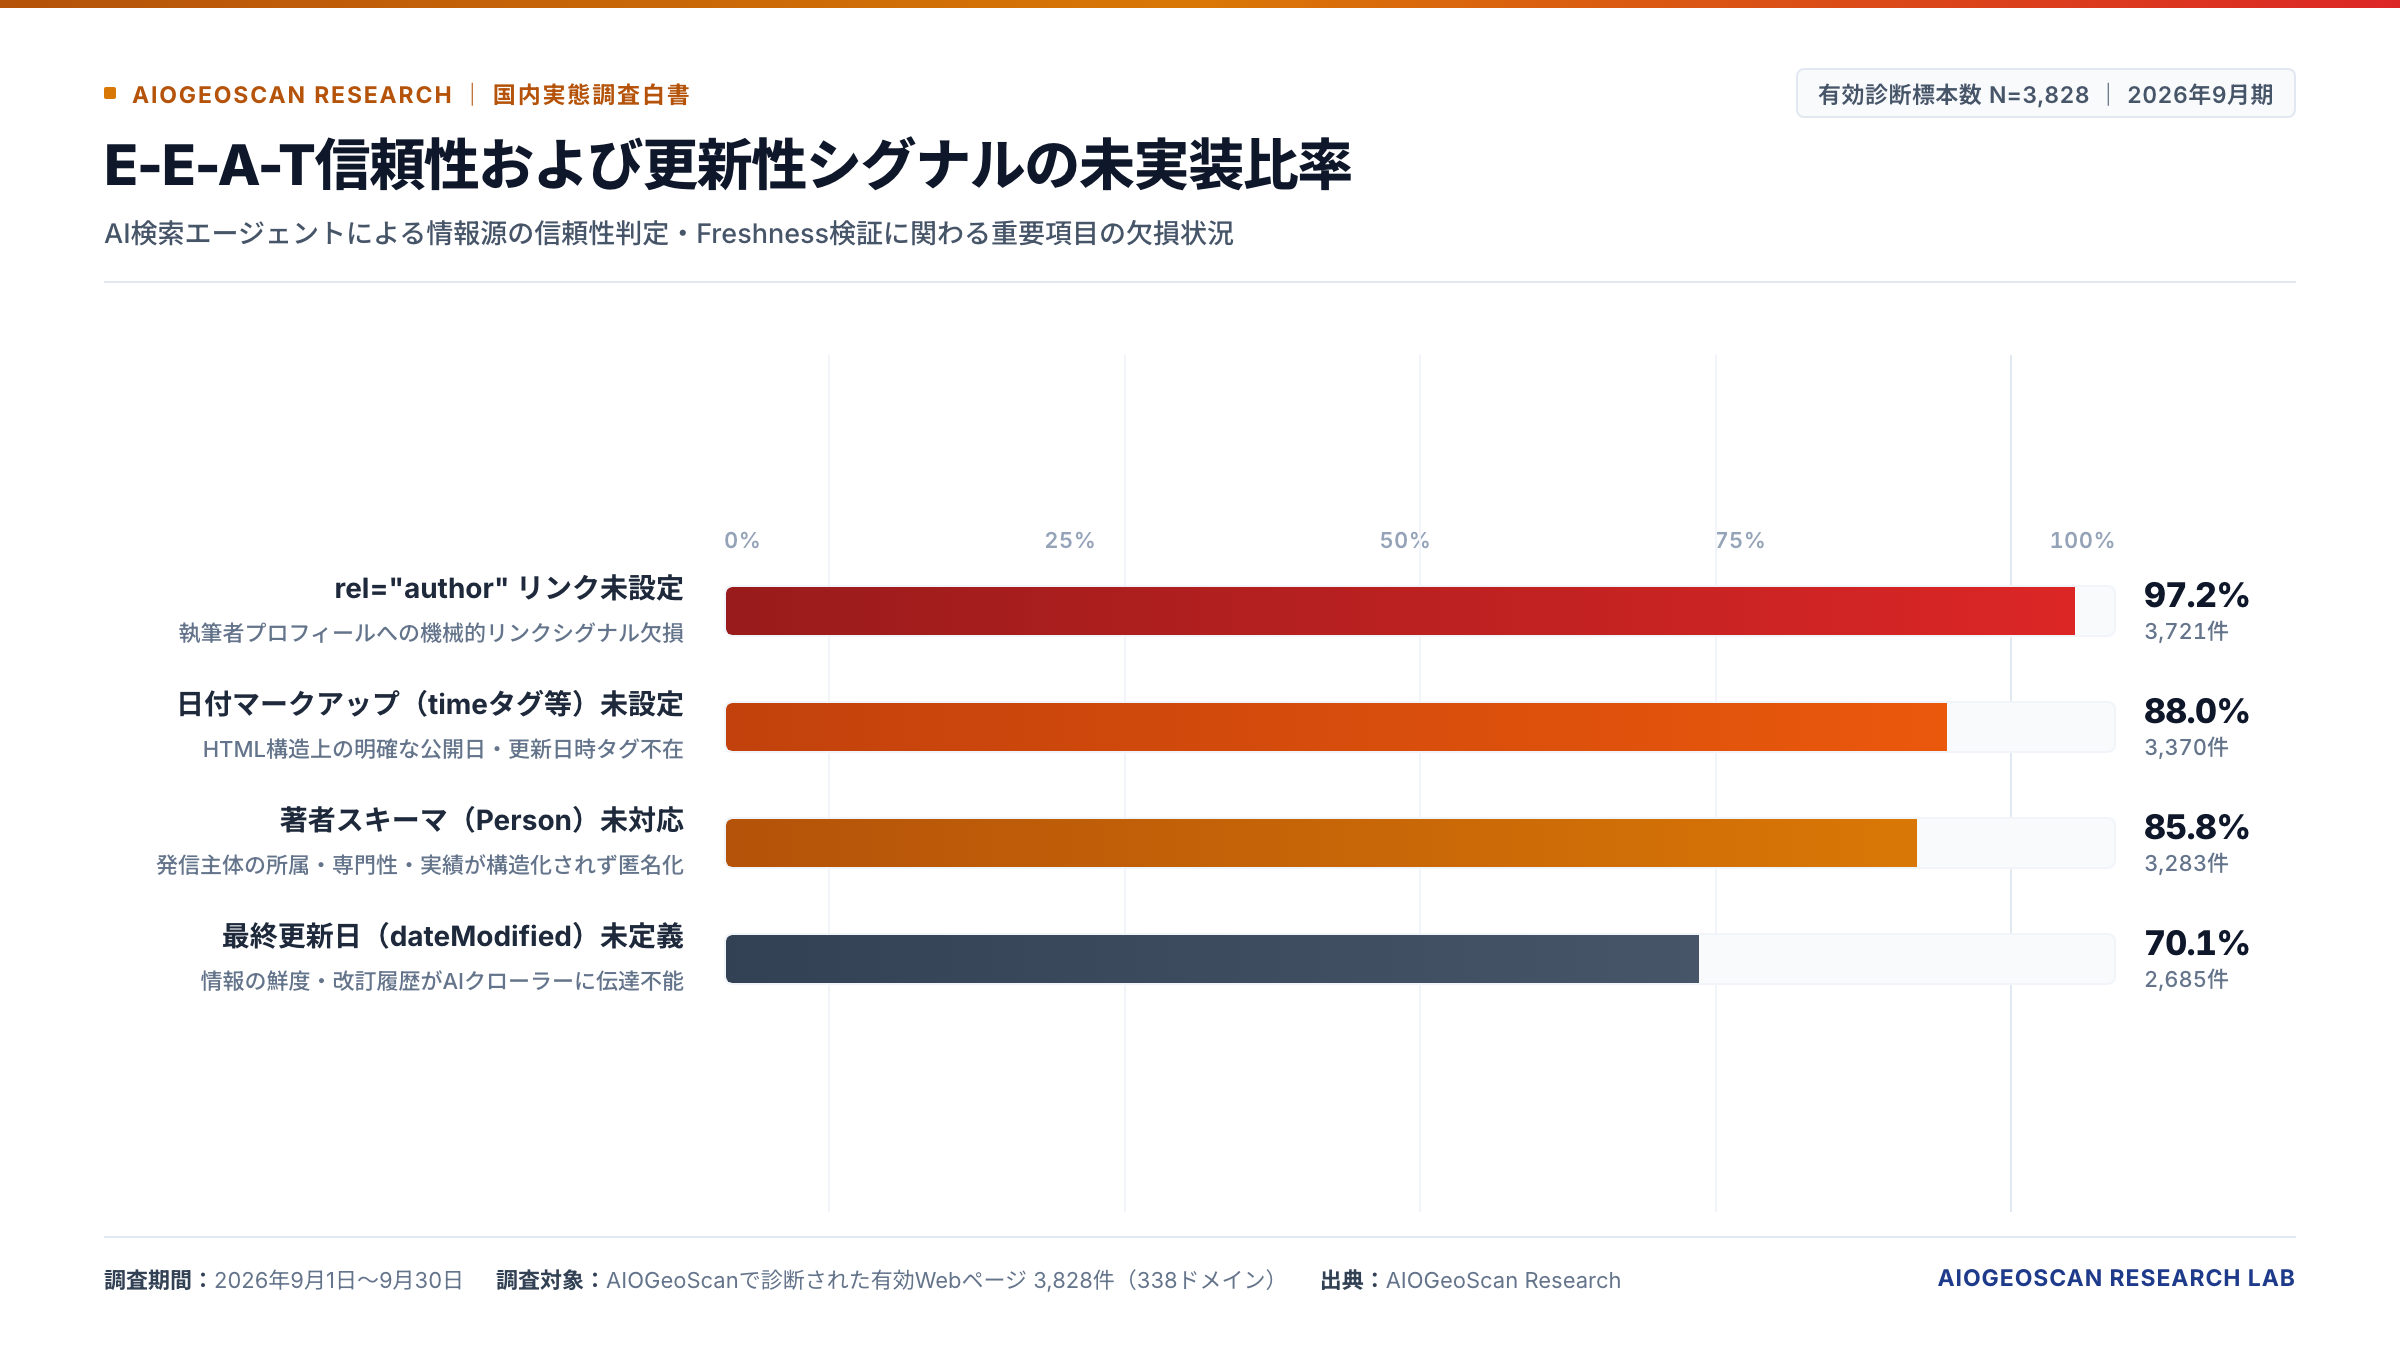
今月検出されたMedicalClinic(217件)等のデータをケーススタディとして分析すると、著者スキーマ未対応率85.8%、rel="author"未設定率97.2%と、客観的検証シグナルの不足が顕著。高度な正確性が求められる領域において、AI回答空間からの除外を回避するための構造化が急務となっています。
本調査は、AIOGeoScanで診断が実行された有効個別URL 3,828件(338ドメイン)のログを統計集計したものです。自発的にAI適合性診断を実施した企業群を対象としているため、国内Webサイト全体平均と比較して一定のデジタル感度が高い層への選択バイアス(Selection Bias)を含みます。それにもかかわらず8割超でアンサーターゲット不備、半数で構造化データ未実装が確認された点は、市場全体における構造課題の根深さを示唆しています。
- 1. 検索情報流通のパラダイムシフト:ゼロクリック検索と引用シェア(Citation Share)
- 2. 2026年9月期 実測診断データに見るAIO不適合指標の全体像(N=3,828)
- 3. RAG・情報検索アーキテクチャから見た「アンサーターゲット構造」の数理的・技術的解明(警告率 86.2%)
- 4. 「浅い構造化データ(Shallow Schema)」の病理とナレッジグラフ空洞化(未実装率 50.7%)
- 5. 注目分野のケーススタディ:医療(MedicalClinic)に見るE-E-A-T機械検証の技術課題
- 6. 「コンテキストウィンドウの経済学」から見た llms.txt の本質(未設置率 89.5%)
- 7. 産業への戦略的示唆:AIエージェント時代におけるWebサイトの再定義と開発組織の変革
- 8. 結論と提言:ゼロクリック検索環境下で企業が講ずべき3つの構造的アプローチ
1. 検索情報流通のパラダイムシフト:ゼロクリック検索と引用シェア(Citation Share)
1.1 「ポータル型インデックス」の終焉と「自律型アンサーエンジン」の台頭
インターネット黎明期より四半世紀にわたりWebエコシステムを支配してきた検索の基本原則は、「ユーザーの意図に適したWebページへのハイパーリンクを提示する(ディスパッチ型ポータル)」というモデルでした。検索エンジンはトラフィックの分配者であり、Webパブリッシャーは検索結果一覧(SERP)の上位表示を獲得することで訪問者を獲得してきました。
しかし、大規模言語モデル(LLM)と情報検索(Information Retrieval: IR)技術が融合したGoogle AI Overviews、ChatGPT Search、Perplexity等の台頭は、この前提を根底から解体しました。検索エンジンは、もはやユーザーを外部Webサイトへ転送する中間ハブではなく、膨大なWebコーパスから必要な情報を自ら抽出し、要約・構造化して最終回答を提示する「自律型アンサーエンジン(Answer Engine)」への構造的な転換が急速に進行しています。
1.2 「ゼロクリック検索」の常態化とオーガニック順位の価値減耗
この技術的転換がもたらした直接的帰結が、「ゼロクリック検索(Zero-Click Search)」の急速な拡大です。ユーザーはSERP上で疑問の直接的な解答を得るため、外部サイトへ遷移するインセンティブが構造的に喪失します。
従来のSEOにおけるKPIであった「特定キーワードの掲載順位」や「検索結果インプレッション数」は、トラフィックや事業収益との相関性を急激に喪失しています。上位1〜3位にランクインしていたとしても、AIの回答ブロックがファーストビューを独占し、ユーザーの検索目的を完結させてしまえば、クリック率は従来の数分の一へと減衰します。
1.3 新たな経営指標「引用シェア(Citation Share)」と高エンゲージメント獲得
ゼロクリック環境下において、企業のデジタルプレゼンスを決定づける唯一の指標は、生成されたAI回答の「論拠・参照元(Source Citations)」として自社コンテンツが選定される確率、すなわち「引用シェア(Citation Share)」です。
AIアンサーエンジンが提示する引用リンクは、従来の無機質なリンクの羅列とは本質的に異なり、「AIが専門的判断に基づき信頼に足ると認定した客観的根拠」としての強力な権威性を帯びます。その結果、引用経由で流入するユーザーは極めて高い購買・検討意向(High Intent)を持ちます。企業が自社のブランド価値、思想、プロダクトの優位性を市場に浸透させるためには、AIモデルの回答生成パイプラインに対して、自社の情報資産を「最も抽出・引用しやすいセマンティック構造」へと再構成することが経営上の至上命題となっています。
2. 2026年9月期 実測診断データに見るAIO不適合指標の全体像(N=3,828)
2.1 標本母集団の属性とサンプリング特性
2026年9月期において、AIOGeoScanプラットフォームで診断が実行されたセッション数は過去最多の449セッション(サイトマップ検出総URL数 233,175件)に達し、その中から詳細なDOM解析およびセマンティック検証が完了した有効個別ページ3,828件(338ドメイン)を分析対象としました。
本調査の標本は、自発的に自社サイトのAI検索適合性診断を実施した先進的な企業・Webマスター群のデータであり、一般的な国内Webサイト全体平均と比較して一定の「デジタル感度・最適化意識が高い層」への選択バイアス(Selection Bias)を内包します。したがって、本レポートで示される不適合率は市場平均と比較して保守的な値であり、市場全体の実態は本数値を大幅に上回る深刻な構造不全を抱えていると推認されます。
2.2 主要AIO不適合・警告項目の全体構造
有効診断ページ3,828件における主要警告指標の検出状況は、国内Webサイトが抱える「AI適合性の構造的断絶」を如実に示しています。
特筆すべきは、全標本の86.2%において「アンサーターゲットの欠落」が確認され、85.8%において「発信者スキーマ(Person)の欠損」が認められた点です。これは、Webサイトの制作・運用において、依然として「旧来型の人間視覚向けレイアウト」と「匿名の企業情報発信」が惰性的に踏襲されており、AIクローラーが要求する数理的・意味論的基準に応えられていない現実を明確に裏付けています。
3. RAG・情報検索アーキテクチャから見た「アンサーターゲット構造」の数理的・技術的解明(警告率 86.2%)
3.1 RAG(検索拡張生成)パイプラインの数理的メカニズム
AI検索エンジンがユーザーのクエリに対して回答を生成する際、対象Webページ全体をそのままLLMに直接流し込むことは、計算量(計算複雑性)およびコンテキストウィンドウの物理的制約から不可能です。したがって、現代の検索エンジンはすべてRAG(Retrieval-Augmented Generation)パイプラインを採用しています。
RAGの検索アーキテクチャは、主として以下の2段階(二段構え)の検索・再ランキング処理によって構成されます:
- 第1段階:Dense Retrieval(Bi-Encoderによる高速一次スクリーニング)
クエリと事前にチャンク分割されたWebパッセージを、独立したエンコーダー(Bi-Encoder)によって高次元ベクトル空間に写像し、内積またはコサイン類似度によって近傍探索を行い、上位候補(Top-K)を高速抽出します。 - 第2段階:パッセージ再ランキング(Cross-Encoder / ColBERT Late Interaction)
抽出された上位候補パッセージに対し、ColBERT等のモデルを用いてクエリートークンとパッセージトークン間の相互作用(MaxSim演算:各クエリートークンに対する最大類似度トークンの総和)を計算し、厳密な関連度スコアを算出します。
3.2 なぜ「アンサーターゲット」の欠落がスコアの急減衰を招くのか
本調査において86.2%(3,300ページ)で警告が検出された「アンサーターゲット構造の不備」は、まさにこのRAGプロセスの初期段階における重大な阻害要因となり得ます。HTMLの主要見出し(H2/H3)直下に、その見出しに対する直接的な結論・要約テキスト(50〜150文字程度)が存在しない場合、以下の数理的減衰が生じます:
① チャンキング境界と情報密度(Information Density)の希釈
RAGのチャンキング処理(256〜512トークン分割)において、見出し直下に装飾バナー、冗長な前置き挨拶文、広告等が介在する場合、生成されるチャンク内部においてクエリの核心に答える「有効情報トークン」の占有率が激減します。ベクトル空間におけるパッセージの埋め込み表現は、ノイズトークンが大量に混入することで直交化・分散し、クエリベクトルとのコサイン類似度が大幅に低下します。
② ColBERTのMaxSim演算におけるトークンアテンションの減衰
ColBERT型のLate Interactionモデルでは、クエリの各トークンに対して最も高い類似度を持つパッセージ側トークンの最大内積を合算します。見出し直下に明確な「主語+述語+定義(アンサーターゲット)」が存在すれば、クエリの疑問詞や名詞トークンに対してパッセージ側の先頭トークン群が瞬時に極めて高い類似度を返します。しかし、回答が段落の後半に埋没している場合、最大類似度トークンが特定できず、総スコアがパッセージリランキングの足切りラインを下回ることになります。
3.3 セマンティック工学としての「結論ファースト(Inverted Pyramid)」
伝統的なジャーナリズムにおける「逆ピラミッド型記述(最も重要な結論を先頭に書き、背景や詳細は後続に述べる手法)」は、AI検索時代において、単なる読みやすさの工夫ではなく、「RAGパイプラインの情報抽出効率を最大化するための厳密な工学的要件」へと昇華しました。
見出し直下の50〜150文字は、LLMがダイレクトアンサーを合成する際の「最小抽出ユニット(Minimum Extractable Unit: MEU)」として機能します。86.2%のサイトがこの構造を満たしていない現実は、国内企業のコンテンツ資産の大部分が、AIアンサーエンジンから見て「ノイズ過多で引用不適格」と判定されている実態を証明しています。
4. 「浅い構造化データ(Shallow Schema)」の病理とナレッジグラフ空洞化(未実装率 50.7%)
4.1 未実装率50.7%の表層的改善と「質の空洞化」
2026年9月期の調査において、JSON-LD等の構造化データが全く実装されていないページの割合は50.7%(1,941件)を記録しました。前月(58.7%)から約8ポイントの改善を見せ、Webマスターの間で構造化データへの意識が高まりつつある兆候が窺えます。
しかし、実装されているスキーマ型の内訳を詳細に解剖すると、極めて深刻な「構造的空洞化」が進行している実態が判明しました。
4.2 「浅い構造化データ(Shallow Schema)」の病理
上位を占めるのは、`BreadcrumbList`(35.5%)や `WebSite`(32.5%)、`Organization`(29.4%)といった、主要CMSや汎用テーマがプラグインや初期設定によって自動的・画一的に出力する「外枠のメタデータ」に偏重しています。
その一方で、Webページの核心的資産であるコンテンツ自体の意味を定義する Article はわずか10.2%、執筆者の実体を示す Person は7.1%、AIの直接回答抽出に直結する FAQPage に至っては4.0%に過ぎません。
この現象は、トップアナリストが警鐘を鳴らす「浅い構造化データ症候群(Shallow Schema Syndrome)」の典型例です。「構造化データを記述している」という形式的チェック項目はパスしていても、出力されているのはサイト全体のナビゲーション情報のみであり、AIクローラーが最も解釈を求めている「このページは何についての知見であり、誰が執筆し、どのエンティティと関連しているのか」という肝心のコア情報が完全に脱落しています。
4.3 エンティティ曖昧性解消(Disambiguation)の失敗と「意味論的孤立」
AI検索エンジンは、Web上の非構造化テキストを処理する際、背後にある巨大なナレッジグラフ(Knowledge Graph)と照合し、語句が指し示す現実世界の概念(エンティティ)を特定する「曖昧性解消(Entity Disambiguation)」を実行します。
例えば、「アップル」という文字列が「果物のリンゴ」なのか「テクノロジー企業のApple Inc.」なのかを判別するプロセスです。人間であれば文脈から容易に判読できますが、LLMやクローラーにとって、構造化されたメタデータが存在しないWebページは、単なる確率的なトークン列に過ぎません。
Article スキーマや Person スキーマが欠落したサイトでは、AIはテキストマイニングによる確率的推論に依存せざるを得ず、抽出の確信度(Confidence Score)が著しく低下します。さらに深刻なのは、単一ページ内に複数のスキーマが記述されていたとしても、それらが @id によるハイパーグラフ(Linked Data)として結合されておらず、断片的なオブジェクトとして散在している点です。自社ドメインのコンテンツ資産を、Googleナレッジグラフや外部オントロジー(Wikidata等)と結びつける強固な「セマンティック・アンカー」を持たないサイトは、AI検索の世界において「意味論的孤立(Semantic Isolation)」に陥っています。
5. 注目分野のケーススタディ:医療(MedicalClinic)に見るE-E-A-T機械検証の技術課題
5.1 データ検出の背景:特定領域の診断蓄積とケーススタディの位置づけ
2026年9月期のデータセット(3,828件)において、スキーマ普及率ランキングで注目すべき点として、MedicalClinic スキーマが5.7%(217件)で第7位に検出された点が挙げられます。これは特定の医療法人や専門クリニック関連サイトにおける一括診断・継続診断の蓄積などが反映された結果と推察されますが、同時に、高い正確性と信頼性が厳格に問われる医療・YMYL(Your Money or Your Life)分野におけるサイト構造の実態を浮き彫りにしています。
人の生命や健康、財産に直結する医療領域では、AI検索エンジン(Google AI OverviewsやPerplexity等)がハルシネーション(虚偽情報の生成)を抑止するため、情報ソースの採用基準を極めて厳格に設定しています。本章では、今月一定規模のデータが蓄積された医療分野をケーススタディ(注目領域)としてピックアップし、E-E-A-T(専門性・権威性・信頼性)の機械的可読性における技術的実態と課題を考察します。
5.2 「人間向けの信頼性表現」と「機械検証可能性」の乖離
医療・YMYL領域においてAI検索が回答の参照元として採択するための不可欠な前提条件は、「その医療見解を発信している医師・監修者は誰か」「所属機関や客観的な専門性エビデンスが存在するか」というE-E-A-Tシグナルの機械的検証可能性(Algorithmic Verifiability)です。
しかし実測診断データが示す通り、診断されたページ群の85.8%において執筆者を示す Person スキーマが未対応であり、97.2%においてHTML標準の rel="author" 属性リンクすら配置されていません。Webページ上に院長写真や経歴が人間向けに掲載されていても、プログラムから直接参照可能なメタデータとしては「発信主体が特定困難なテキスト」と同等に扱われてしまう技術的実態が浮き彫りとなっています。
5.3 更新性の機械可読性と「Digital Dark Matter(デジタル暗黒物質化)」の回避
さらに、情報の鮮度や更新性を担保する dateModified(未定義率 70.1%)やセマンティックな <time> タグ(未設定率 88.0%)の未実装も高水準です。日進月歩の医療分野において、公開日や改訂履歴が機械的に読み取れないドキュメントは、AIクローラーのナレッジ更新サイクルにおいて引用候補から除外されやすくなります。
【E-E-A-T機械検証の技術的観点】
人間から見たWebページ: 洗練された院長紹介写真、クリニック設備、診療説明テキストなどにより、人間は「信頼できるクリニック」と判断可能。
AIクローラー・LLMから見たWebページ: Personスキーマ不在、rel="author"不在、医師免許・所属学会リンク(sameAs)不在、dateModified不在 ⇒ 発信主体や更新性のプログラム検証が困難となり、高信頼性が要求される回答生成時の引用対象として採択されにくくなる。
人間の目には「信頼できる専門クリニックのサイト」に見えても、AI検索エンジンのアルゴリズムにとっては「発信者の実体が機械検証できないページ」として扱われるリスクがあります。どれほど質の高い専門知識を提供していても、機械検証可能な構造化データやセマンティックHTMLを備えていなければ、AI検索空間において情報が存在しないに等しい状態(Digital Dark Matter)に陥ってしまいます。医療分野に限らず、専門性や信頼性を強みとするすべてのWebサイトにおいて、E-E-A-Tシグナルの構造化は不可欠な基盤といえます。
6. 「コンテキストウィンドウの経済学」から見た llms.txt の本質(未設置率 89.5%)
6.1 llms.txt をめぐる浅薄な理解の打破
AIエージェントやLLMがWebサイトの主要コンテキストを効率的に把握するための提案仕様として注目される `llms.txt` の未設置率は 89.5%(全量推計 3,426件)を記録しました(※サイト単位のルート配置仕様に基づき、診断URLの所属ドメイン群における整備状況を展開・推計)。
現在、多くのWebディレクターやマーケターは、`llms.txt` を「robots.txt の焼き直し」「AIクローラーに対する新しい拒否・許可の構文」程度に誤認しています。しかし、この認識は技術的本質から著しく乖離しています。
6.2 「コンテキストウィンドウの経済学」:LLM推論の3大物理的制約
自律型AIエージェント(Perplexity、ChatGPT Search、Google Gemini Agent等)がWebを自律的に探索し、ユーザーの複雑なプロンプトに対してリアルタイムに回答を導出するプロセスには、極めてシビアな物理的・経済的制約が伴います:
- 1. 推論コスト(Inference Cost): LLMの推論処理にかかる計算費用は、入力トークン数に対して比例(Transformerモデルの計算量としては二乗的影響)して増大します。
- 2. 推論レイテンシ(Latency): 数万トークンに及ぶHTMLソースコードを読み込ませることは、ミリ秒単位の応答速度を競うリアルタイム検索において許容されない遅延を生みます。
- 3. アテンション減衰(Lost in the Middle現象): LLMは、コンテキストウィンドウが長大化するにつれて、入力文書の中央部分に記述された重要情報を適切に参照できなくなる「中央埋没現象」に直面します。
6.3 AIエージェントへの「高純度コンテキスト注入インターフェース」
llms.txt の真の本質は、ノイズに塗れたHTML DOMからコンテンツを苦労してスクレイピングさせるのではなく、「Webサイトの全容、コアとなる理念、主要ドキュメントの要約、API仕様」を、極限まで情報密度を高めたMarkdown形式でLLMに直接提供する「セマンティック・ショートカット(高速コンテキスト注入基盤)」である点にあります。
AIエージェントにとって、無駄な装飾タグや広告が排除され、整理された構造で提供される llms.txt は、推論コストを最小化し、ハルシネーションを防止するための「極めて好ましい情報源」となります。
未設置率89.5%という数字は、国内企業の約9割が、自律型AIエージェントに対して「高い推論コストと読解ストレスを強いる不親切なインターフェース」を放置していることを意味します。先行して高品質な llms.txt および llms-full.txt を配備した上位10%の企業は、AI検索エージェントによる探索・引用の優先権を享受する強力な非対称の競争優位を確立しつつあります。
7. 産業への戦略的示唆:AIエージェント時代におけるWebサイトの再定義と開発組織の変革
7.1 Webサイトの存在定義の転換:「人間向けGUI」から「AI向け機械可読API基盤」へ
3,828件の実測データが突きつける最大の戦略的示唆は、「Webサイトの主たる消費者が、人間からAIエージェントへと不可逆的にシフトした」という産業構造の変化です。
過去四半世紀のWebサイト構築は、人間の視覚認知を刺激する「リッチなグラフィックデザイン」「アニメーション演出」「心理的CV導線」に最適化されてきました。しかし、ユーザーとWebコンテンツの間にLLMが介在し、コンテンツの解釈と選別をAIが代行する世界においては、視覚的な美しさはAIによる引用採択率に何ら寄与しません。
これからのWebアーキテクチャは、「人間向けの優れたグラフィックUI(GUI)」としての役割を維持しつつも、その本質において「自律型AIクローラーが高効率にデータを取得できる機械可読なAPI基盤(Data Interface)」としての機能を二重に具備しなければなりません。
Webサイトの設計思想におけるパラダイムシフト(比較対照)
| 比較項目 | 従来型Web設計(〜2024) | 次世代AIO/GEO設計(2026〜) |
|---|---|---|
| 第一義的対象 | 人間の眼球(エンドユーザー) | AIクローラー・推論エージェント |
| 評価の主軸 | 視覚デザイン・滞在時間・直帰率 | 情報密度・セマンティック純度 |
| 構造記述 | HTMLレイアウトの整頓 | Linked Data(ナレッジグラフ) |
| 検索成功指標 | オーガニック検索順位(Rankings) | 引用シェア(Citation Share) |
| 組織的責任 | マーケティング部 / SEO担当 | エンジニアリング統括 / CTO |
7.2 開発現場のサイロ解体と「セマンティック・エンジニアリング」の胎動
従来、SEO施策はマーケティング部門や外部のコンテンツ制作会社に丸投げされ、フロントエンド開発者や情報アーキテクトが関与する領域はCore Web Vitalsのチューニング程度に限定されていました。
しかし、RAGアーキテクチャへの適合(アンサーターゲット構造の実装)、Schema.orgによるナレッジグラフの設計(@graph や @id によるリレーショナル定義)、llms.txt のCI/CDパイプラインへの組み込みは、高度なエンジニアリングスキルと情報幾何学的理解を要求します。
制作会社、SIer、コンサルティングファームの納品定義(Definition of Done: DoD)において、従来の「デザイン再現性」「レスポンシブ崩れなし」に加え、「AIOアンサーターゲット準拠率100%」「Schema.orgエンティティ完全性」「llms.txt適正配備」を必須の品質検収基準として組み込む動きが、業界の新たなデファクトスタンダードになりつつあります。
8. 結論と提言:ゼロクリック検索環境下で企業が講ずべき3つの構造的アプローチ
8.1 結論:セマンティック格差が引き起こすデジタル格差
3,828件の実測ログが示したのは、検索情報流通の競争軸として、従来のドメイン権威性や被リンク規模に加え、「AIが誤解なく引用できるセマンティック基盤を確立できているか」という構造的完全性が、決定的に重要な差別化要因として浮上している現実です。
この変化に対応できない企業は、自社の情報資産が検索結果から不可視化され、トラフィックと認知を喪失し続ける「デジタル暗黒物質」へと転落します。一方、構造的適合を早期に完了させた企業は、ゼロクリック検索環境下であっても、AIの回答空間における圧倒的な引用シェアを独占し、極めて質の高いユーザー接点を獲得し続けることになります。
8.2 企業が講ずべき「3つの構造的アプローチ(Strategic Pillars)」
今後、ゼロクリック検索環境下でブランドの認知と引用シェアを防衛・拡大するために、企業およびWeb技術統括者は以下の3つの構造的アプローチを速やかに推進することが強く推奨されます。
社内コンテンツ制作・編集ガイドラインを全面改訂し、見出し(H2/H3)直後への50〜150文字の要約文配置(アンサーターゲット構文)を制度化・義務付けること。これにより、RAGのチャンキング処理におけるトークンレベルの情報密度を最大化し、ColBERT等のパッセージリランキングにおけるMaxSimスコアの減衰を根絶します。
CMS任せの表層的スキーマを脱却し、@graph 構文を用いて、Organization(運営主体)、Person(著者・専門家)、MedicalClinic(施設・拠点)、Article(知見コンテンツ)を @id で相互参照する強固なリレーショナル・ナレッジグラフを構築すること。あわせて rel="author" および <time datetime="..."> を全ページに機械出力し、エンティティ曖昧性解消とE-E-A-T機械検証を完全に突破します。
自社Webサイトのルート直下に llms.txt および llms-full.txt を即時配備し、自社Webサイトの目的、コアドキュメントの要約、最新の製品・組織データをクリーンなMarkdown形式で定義・常時更新すること。自律型AIエージェントの推論時におけるコンテキスト取得コストを最小化し、アテンション減衰(Lost in the Middle)を防ぐことで、優先的探索・引用の地位を確立します。
報道関係者・研究機関の皆様へ(調査データの転載・取材・共同研究)
株式会社Bennu AIO Research Labでは、本実態調査に関する詳細なクロス集計データ(業種別・ドメイン規模別の不適合比率推移等)の提供、学術研究・報道向けの統計資料提供、およびAI検索最適化(AIO/GEO)に関する取材・執筆・講演の要請を承っております。下記窓口よりお問い合わせください。
- 調査・分析主体:株式会社Bennu AIO Research Lab
- 調査手法:次世代検索適合性診断プラットフォーム「AIOGeoScan」におけるDOM解析およびセマンティックログ集計
- 標本サイズ:2026年9月期 有効個別ページ診断 3,828件(338ドメイン / 累計診断ログ 15,746件)
- データ収集期間:2026年9月1日 〜 2026年9月30日
- 引用・転載規定:本調査の内容、グラフ、数値を報道・論文・資料等に引用・転載する際は、必ず「AIOGeoScan Research調べ(https://aiogeoscan.com/)」と出所を明記してください。