
2026年8月期、AIOGeoScanに蓄積された単月診断データは前月比6倍超の7,803件に達し、大手エンタープライズから中堅・中小企業、地方公共団体、各種メディアに至るまで、より広範な母集団における実態が可視化されました。
分析の結果、生成AI検索の普及が不可逆的に進行する一方、調査対象Webサイトの58.7%で構造化データ(JSON-LD)が全く実装されておらず、AIエージェント向けプロトコルであるllms.txtの未設置率も87.1%に達していることが明らかになりました。標本層の拡大に伴い、早期対応を進める一部の先進層と、従来型HTMLレンダリングにとどまり機械可読性の最適化が進んでいない大多数のサイトとの間で、「セマンティック格差」が顕在化しています。
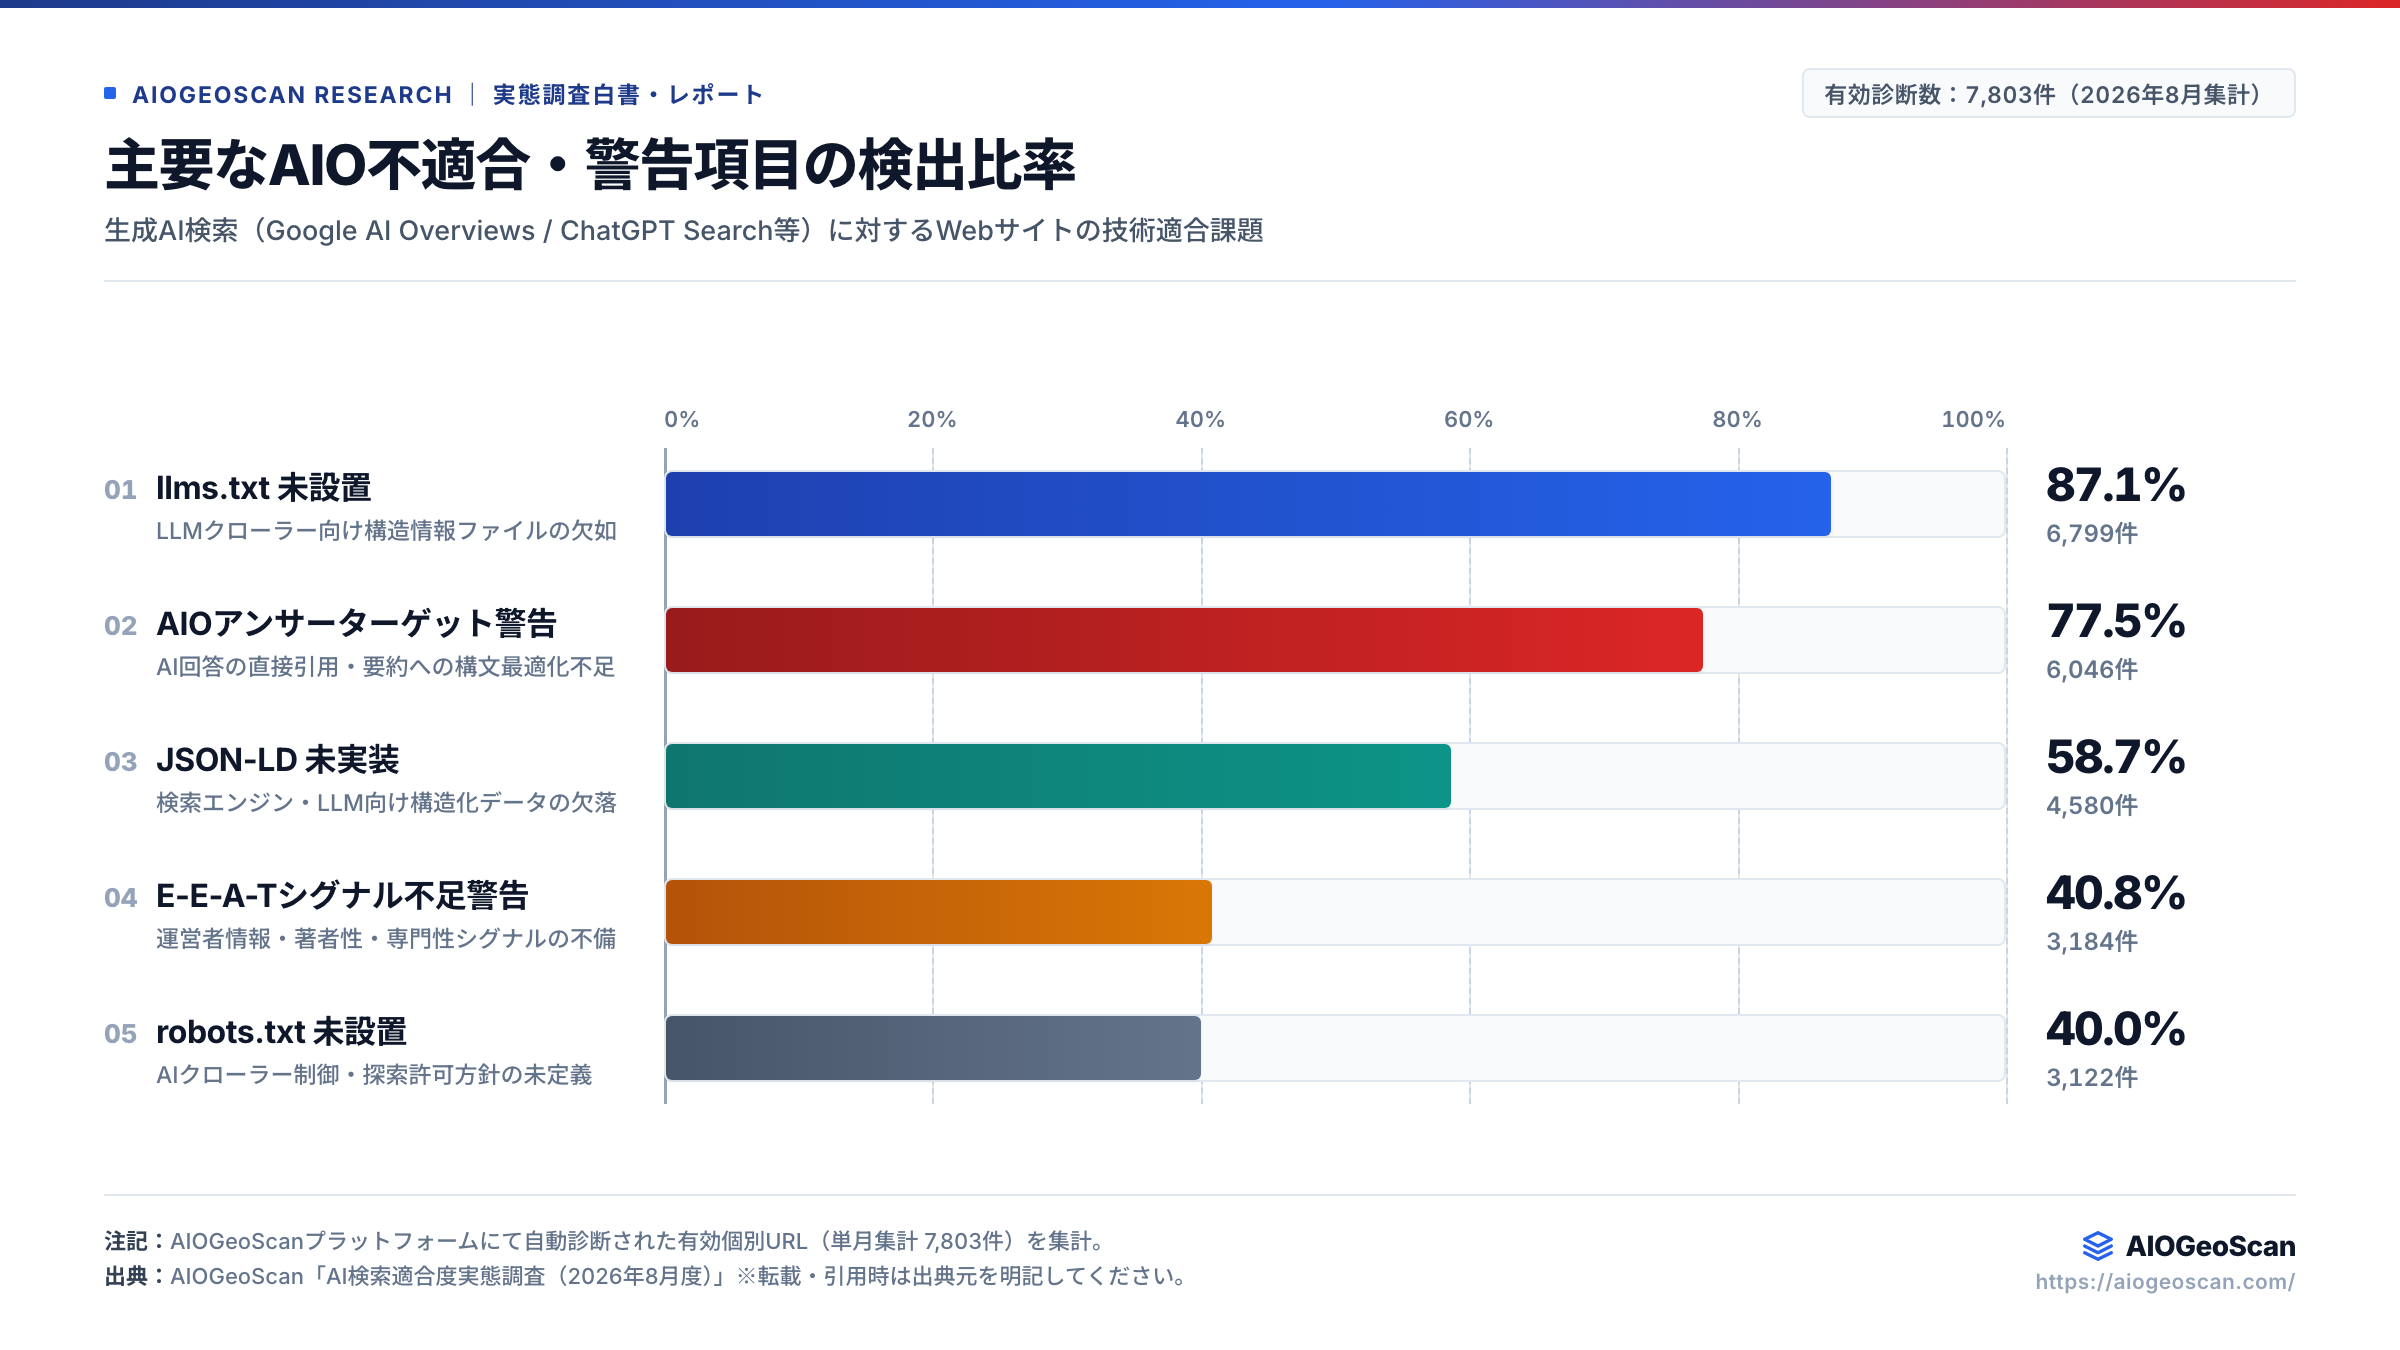
- 構造化データ未実装率58.7%:Web意味論基盤の脆弱性
母集団の拡大に伴い、約6割のサイトにおいてSchema.org準拠のセマンティックタグが不在であることが判明。LLMや検索エージェントによるエンティティ関係の正確な把握を阻害する最大の要因となっています。 - アンサーターゲット不備率77.5%:Dense Retrievalとの構造的不整合
見出し直下に要約テキスト(50〜150文字)を配置しないレイアウトが約8割を占め、情報検索におけるベクトルの類似度計算およびパッセージリランキング段階でのスコア減衰を招いています。 - llms.txt未設置率87.1% & 著者属性未定義率98.7%:AI信頼性評価の空白
AIクローラー向け概要ファイルの普及遅れに加え、ハルシネーション抑制に資する「発信者の客観的同定(E-E-A-T)」がほぼ機能しておらず、AI検索における情報源選定の信頼性スコアを減衰させる要因となっています。
本調査は、AIOGeoScanで診断が実行された有効個別URL 7,803件のログを統計集計したものです。能動的に診断を行うサイト群を対象としているため、一般的なWebサイト全体平均と比較して一定のデジタル関心度が高い層への選択バイアス(Selection Bias)を含みます。それにもかかわらず過半数において未実装が確認された点は、市場全体における構造課題の深刻さを示唆しています。
目次(Table of Contents)
1. 検索情報流通のパラダイムシフト:ゼロクリック検索と引用シェア(Citation Share)
検索エンジンの役割は、長らく「適切なWebページへのリンクを提示するポータル」でした。しかし、Google AI OverviewsやChatGPT Searchの急速な実用化に伴い、検索エンジンは「ユーザーの意図を理解し、直接回答を合成・提示するアンサーエンジン」へと不可逆的な転換を遂げました。
この変革がもたらした最大の事象は、検索結果一覧から個別サイトへの遷移を経ずに問題が解決する「ゼロクリック検索(Zero-Click Search)」の一般化です。従来のSEOにおける最重要指標であった「オーガニック検索順位」や「インプレッション数」は、トラフィック獲得能力との直接的な相関を失いつつあります。
これからの情報流通において企業が獲得すべき指標は、生成されたAI回答の論拠として自社コンテンツが明示的に採用される比率、すなわち「引用シェア(Citation Share)」です。そして、引用の確度を高める上では、コンテンツ自体の独自性や専門性に加え、それらをAIシステムが誤解なく解釈・抽出できる「セマンティック構造の適合性」が不可欠な前提条件となります。
2. 2026年8月期 実測診断データに見るAIO不適合指標の全体像
AIOGeoScanプラットフォームにおいて2026年8月1日〜31日に実施された、有効個別URL 7,803件の診断ログから抽出された主要な不適合・警告指標は下図の通りです。
3. RAG・情報検索アーキテクチャから見た「アンサーターゲット構造」の重要性(警告率 77.5%)
AI検索エンジンがWebページから情報を抽出し、回答を生成する基盤技術は「RAG(Retrieval-Augmented Generation:検索拡張生成)」です。 RAGパイプラインでは、対象ページ全体をそのままLLMに入力するのではなく、見出しや段落単位でテキストを分割(チャンキング)し、ベクトル化(Embedding)して類似度計算を行います。
本調査において77.5%(6,046ページ)で警告が検出された「アンサーターゲット構造の不備」は、まさにこのRAGプロセスの初期段階における致命的な障害となっています。
Dense Retrievalにおける情報密度と類似度スコアの減衰要因
見出し(H2/H3)と、その見出しに対する直接的な回答テキストの間に、装飾用バナー、リード文の冗長な前置き、スクリプトコード、広告等が介在する場合、チャンク内の情報密度(Information Density)が希釈されます。 この結果、ユーザーの検索クエリとチャンクのベクトル空間における類似度が希釈され、ColBERT等のリランキング処理(Reranking)において評価が伸び悩む要因となり得ることが情報検索(IR)モデルの特性から指摘されています。
AI検索における直接引用の確度を高める設計としては、見出しタグの直後(直近位置)に50〜150文字程度の完結した要約ブロック(結論・定義)を配置し、チャンク単位の情報純度を保つアプローチが強く推奨されます。
4. 構造化データ未実装率58.7%が示す「意味論的断絶」と重複定義エラー(411件)の構造分析
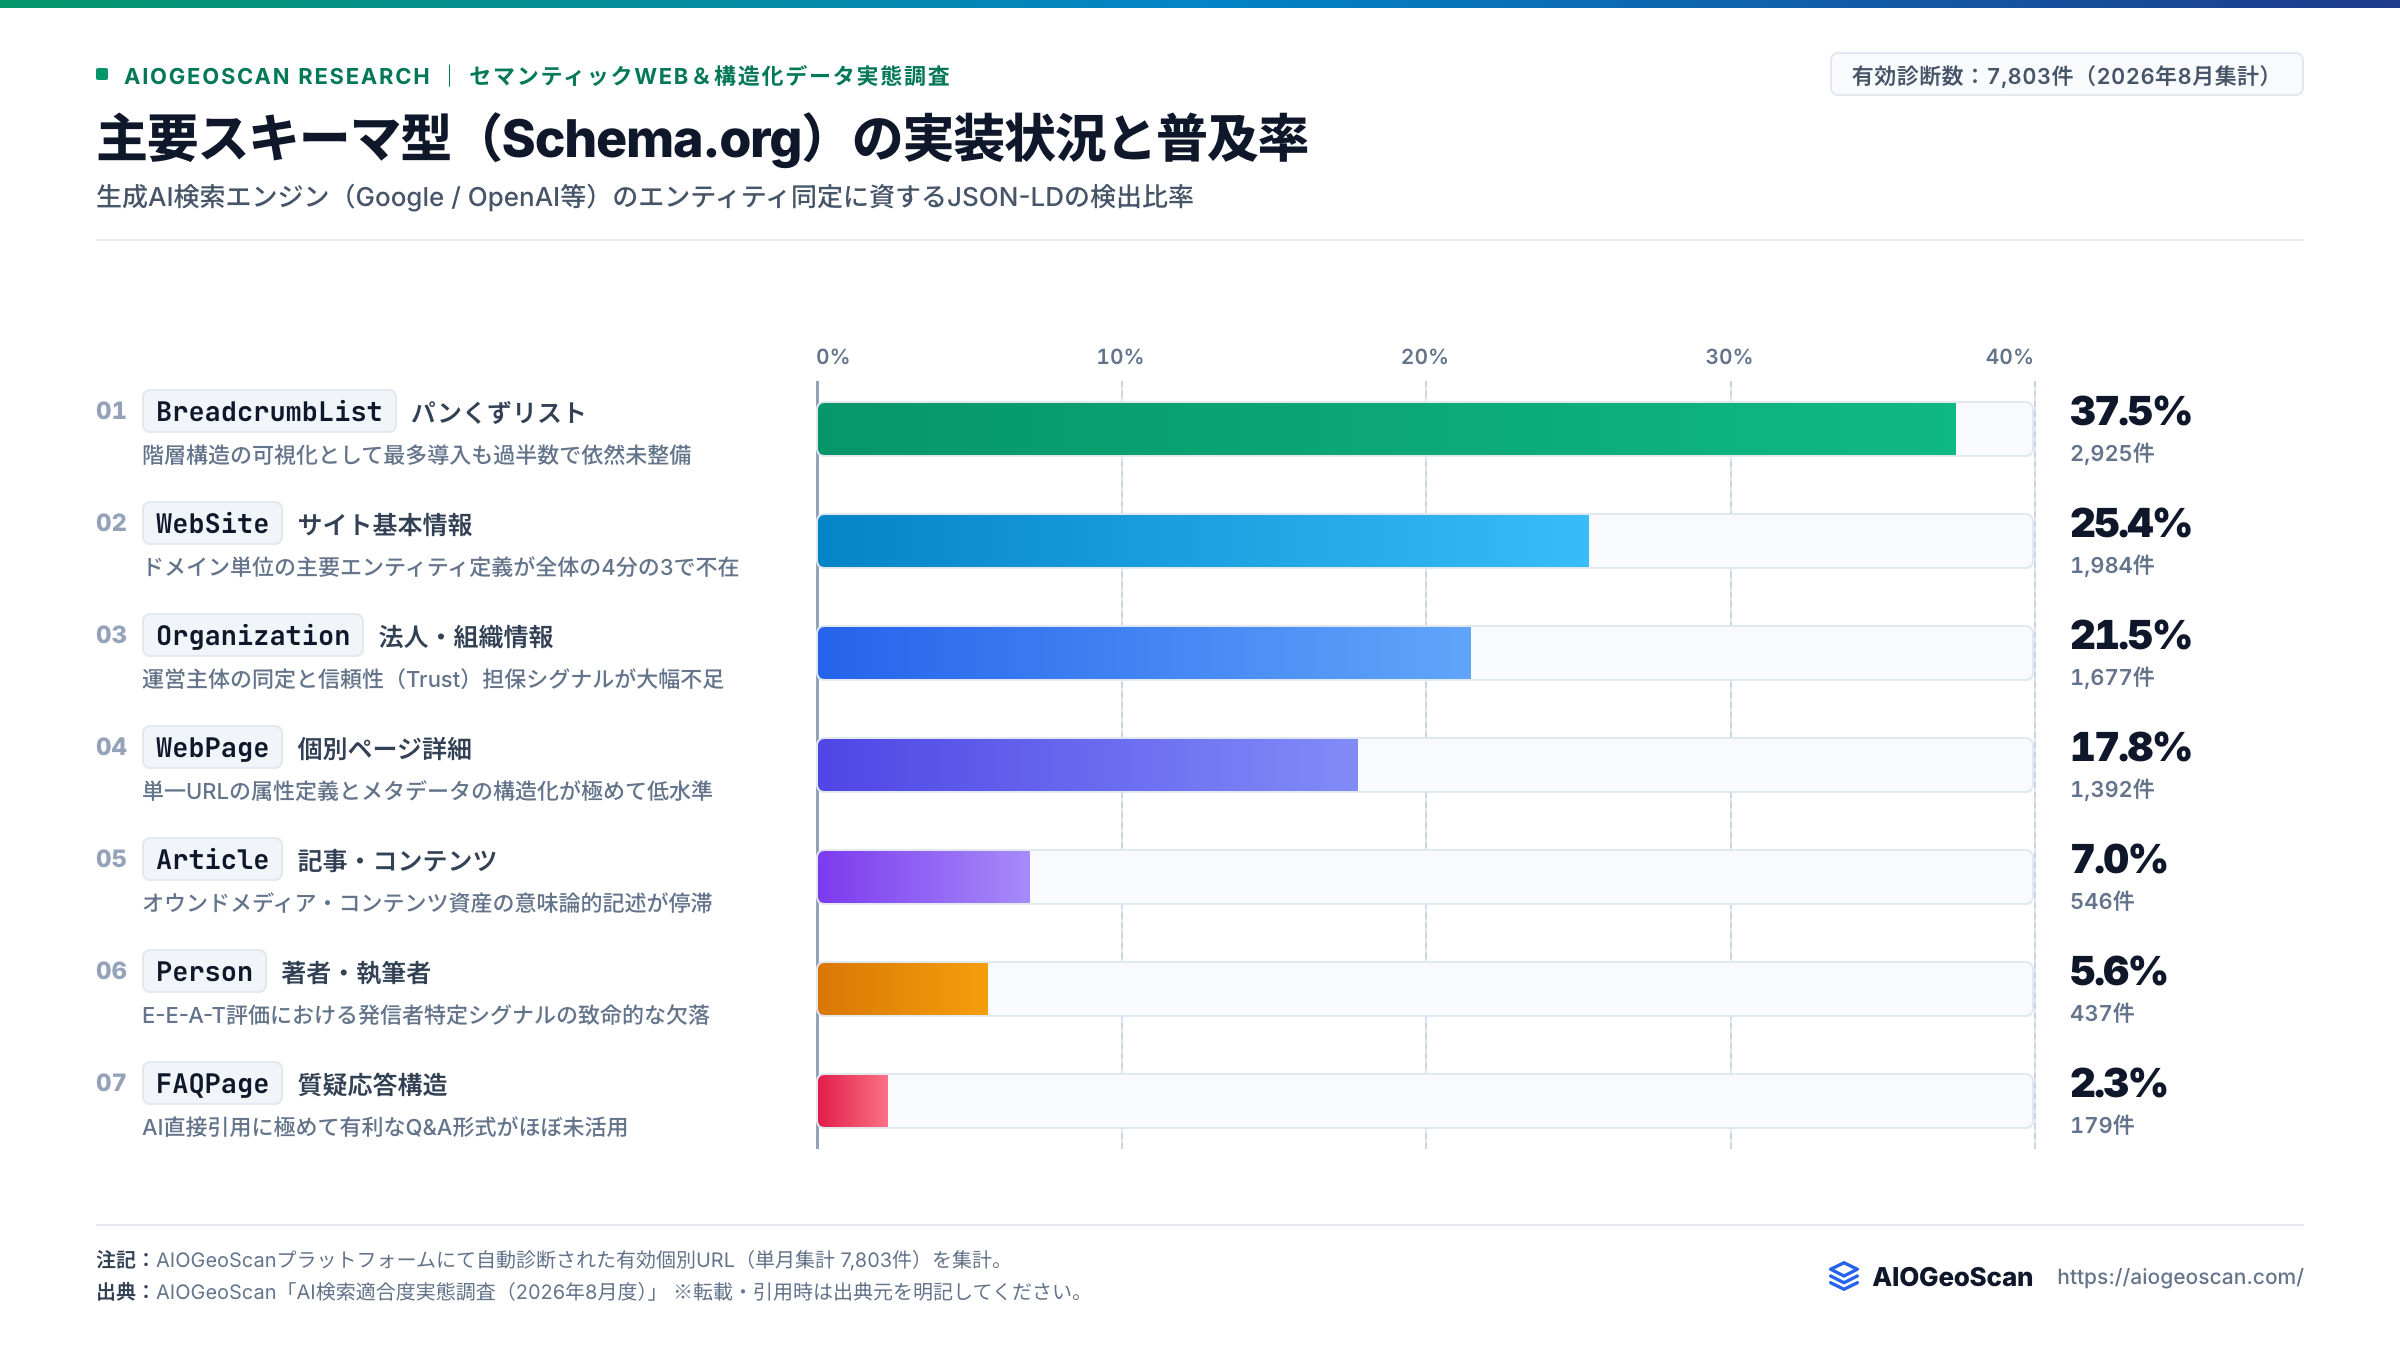
本調査における最も顕著なファクトは、構造化データ(JSON-LD)の未実装率が58.7%(4,580ページ)に達している点です。
人間は視覚的なレイアウトや文脈から「会社名」「サービス価格」「著者」を自然に判別できますが、AIクローラーはDOMツリーをトークンとして処理します。Schema.orgに準拠した構造化記述が欠落している場合、AIシステムは非構造化テキストからの確率的な推定に頼らざるを得ず、エンティティの同定や曖昧性解消(Disambiguation)において誤認や情報脱落のリスクが高まります。
Linked Dataの分断(Graph Fragmentation):重複定義エラー(411件)の弊害
構造化データを導入している上位層においても、技術的整合性における重大な機能不全が確認されました。 8月度において、同一ページ内で同名の `@type`(特に `Organization` や `WebSite`)が別個の script タグで多重定義されている重複定義エラーが411件検出されました。
これは、CMSプラグイン、サードパーティ製タグマネージャー、テーマテンプレートがそれぞれ独立してSchemaを出力することに起因します。この結果、検索エンジン側で「どのノードが真の法人情報か」を判定する際の曖昧性(Entity Ambiguity)が増大し、最悪の場合は構造化データ全体の評価シグナルが無効化されるリスクを孕んでいます。 複数のエンティティを `@graph` プロパティによって単一の接続グラフとして定義するガバナンスが求められます。
5. ハルシネーション抑制とE-E-A-T信頼性シグナル:著者帰属欠落(98.7%)のメカニズム
LLMベースの検索サービスが最も回避すべきシステミックリスクは、虚偽情報の生成(ハルシネーション)に伴う社会的信用の毀損です。この防御策として、各AI検索エンジンは「出所が明確であり、専門家によって執筆・検証された情報源」を優先して引用するアルゴリズムを強化しています。
しかし、8月期の調査ではE-E-A-T(経験・専門性・権威性・信頼性)の機械可読シグナルがほぼ機能していない実態が露呈しました。
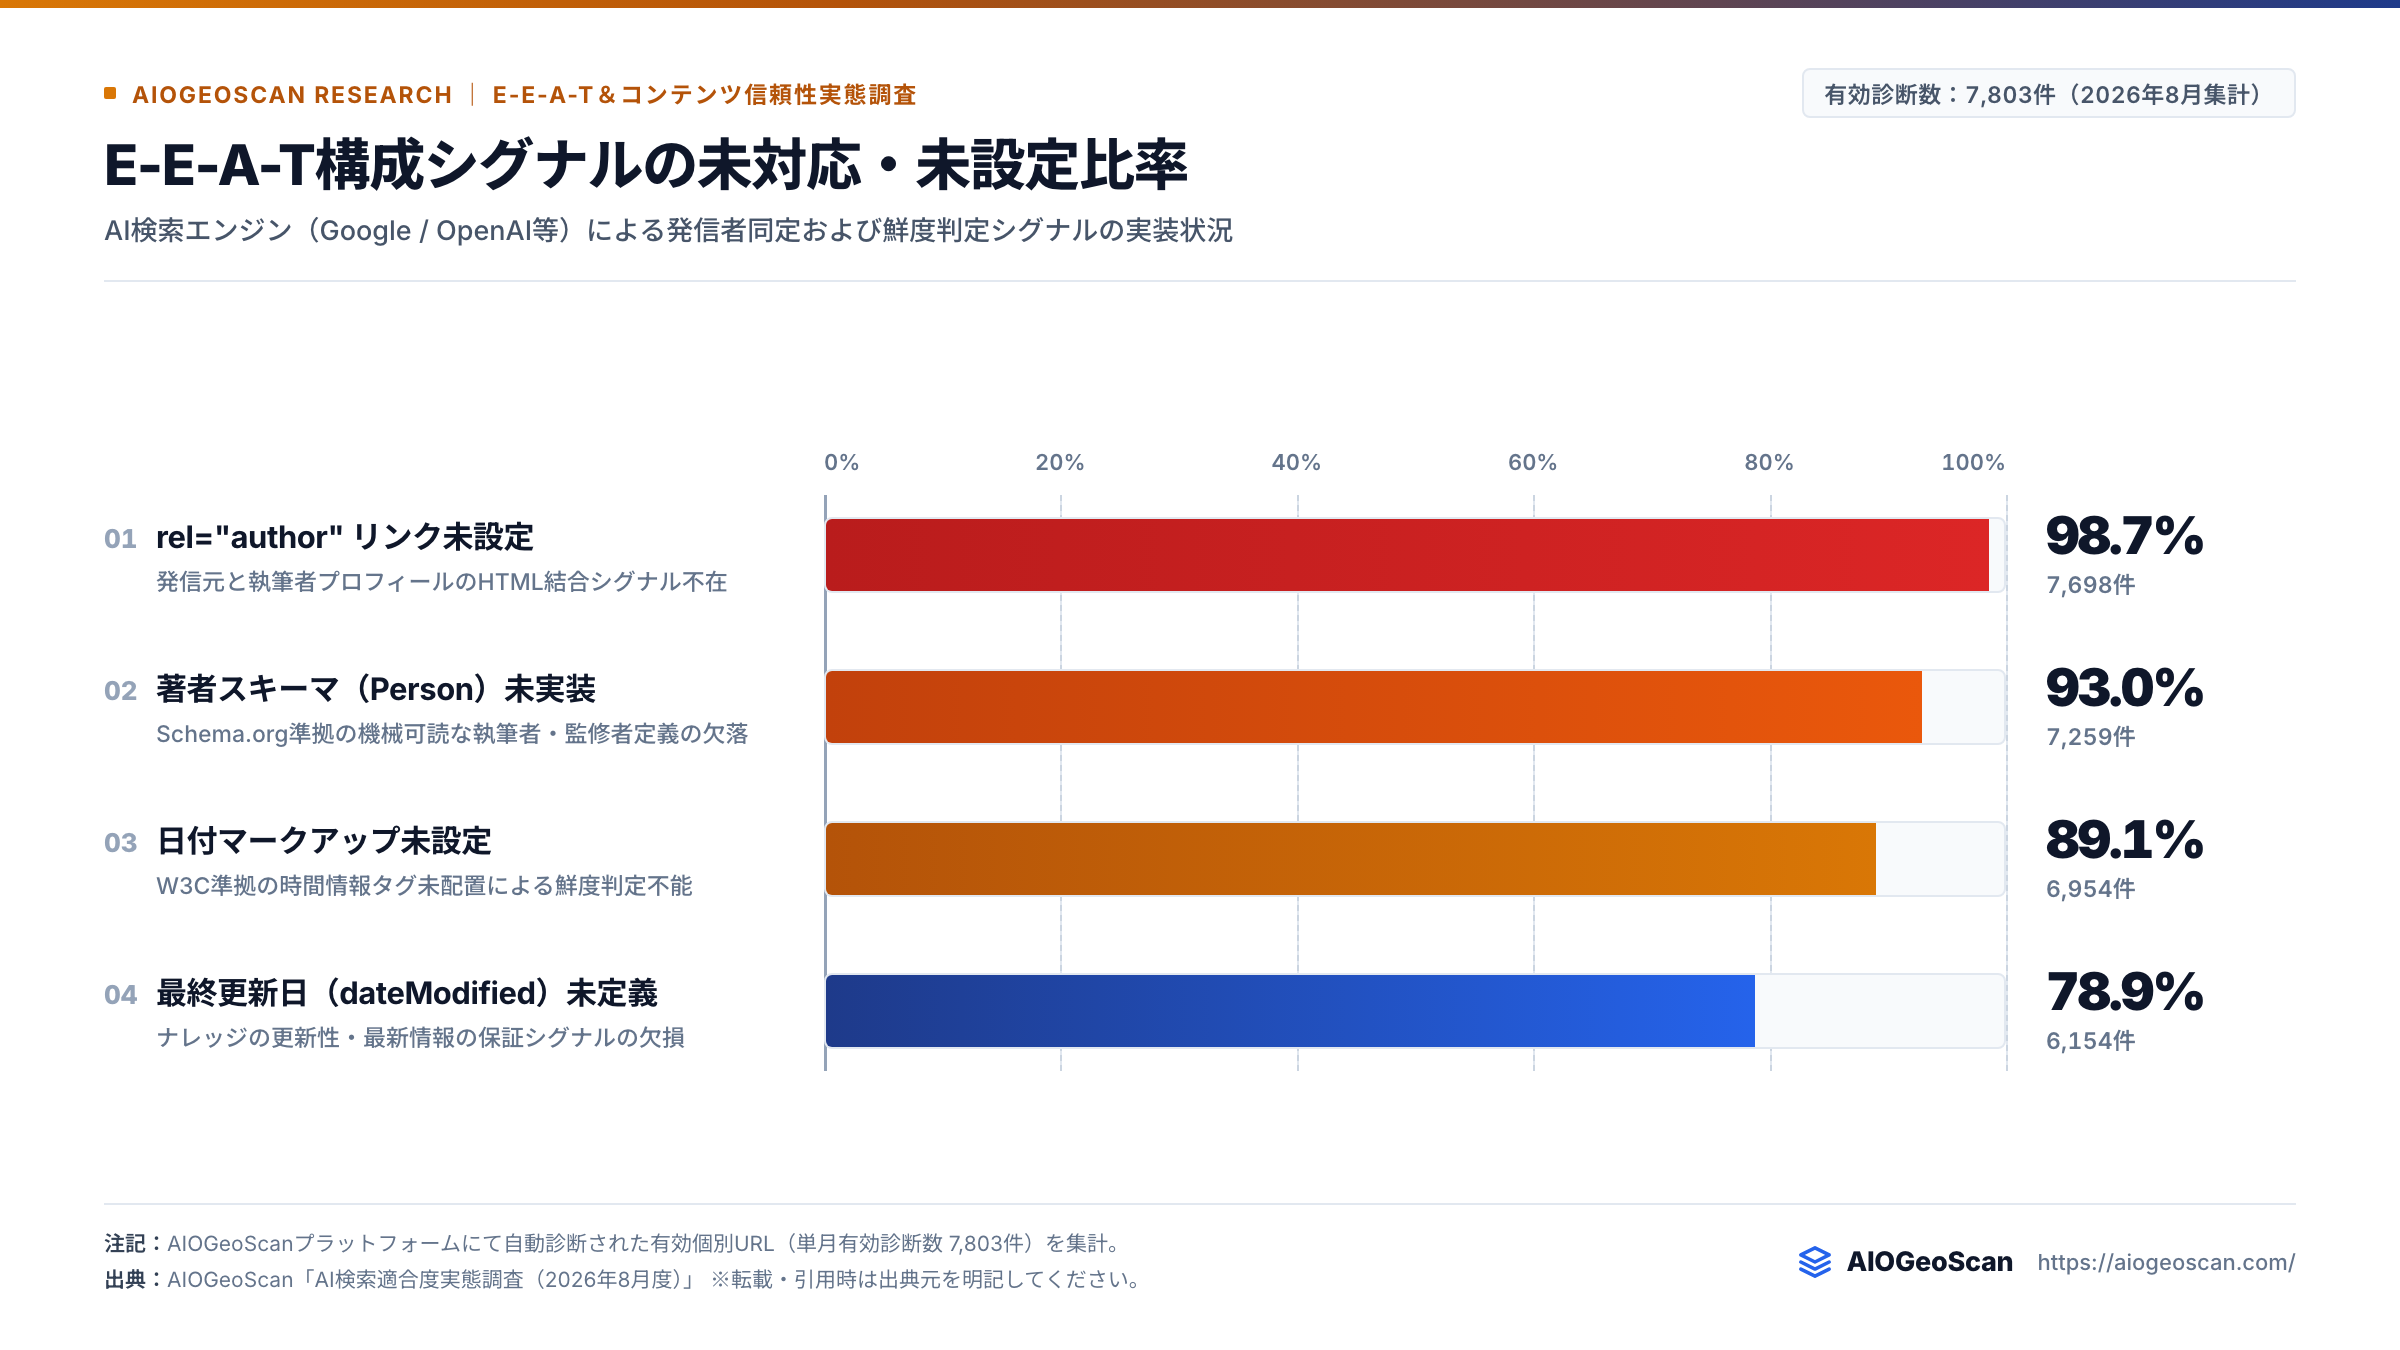
特筆すべきは、発信元の実体と専門性を明示する著者スキーマ(`Person`)の未対応率が 93.0% に上り、HTMLレベルの著者リンク(`rel="author"`)も 98.7% で不在である点です。 客観的な執筆者情報の構造化が欠落している場合、AIシステムによる「誰が発信した情報か」の検証が困難となり、E-E-A-T(経験・専門性・権威性・信頼性)の機械的評価において不利に作用する要因となります。 さらに、time タグ(未設定89.1%)や `dateModified`(未定義78.9%)の不在は、機械的な更新性判定(Freshness)における確信度を低下させ、リアルタイム性や最新情報を重視するAI検索クエリにおいて参照候補から劣後する要因となり得ます。
6. AIクローラビリティとプロトコル統制:llms.txt(未設置率 87.1%)の先行優位性
AIエージェントやLLMがWebサイトの主要コンテキストを効率的に把握するための提案仕様として注目される `llms.txt` の未設置率は 87.1%(6,799件)を記録しました。
従来の `robots.txt`(未設置率 40.0%)が検索クローラーに対する「アクセスの許可・拒否」を規定する静的インフラであるのに対し、`llms.txt` は「自社Web資産の文脈、重要ドキュメントの要約、API情報」をMarkdown形式でLLMに直接教授する「セマンティックなインターフェース」として機能します。
現時点における対象サイト群の対応率は約13%にとどまります。しかし、Perplexity等の自律型AI検索エージェントが回答生成(推論)時にサイトの全体像や重要ドキュメントを迅速に参照・把握する上で、`llms.txt` の配置はコンテキスト取得の効率化に寄与すると期待されています。早期に対応を進めたサイトは、AIによる情報抽出の精度向上や引用の安定化において、先行優位性を築きやすい環境を整えつつあります。
7. 産業への戦略的示唆:AIエージェント時代におけるWebサイトの再定義と開発組織の変革
本調査の分析結果は、企業のデジタルマーケティングおよびWeb制作・開発現場に対して、根本的なパラダイムシフトを要求しています。
Webサイトの再定義:「人間向けグラフィックUI」から「AI向け機械可読API基盤」へ
過去20年間のWeb制作は「人間の視覚に対する訴求(デザイン、アニメーション、視覚導線)」に最適化されてきました。しかし、ユーザーとWebコンテンツの間にLLMが介在する現在、Webサイトの第一の消費者は「AIクローラー」です。 ビジュアルデザインの優位性だけでなく、DOM構造の純度、セマンティックタグ、Linked Dataの整合性といった「機械可読性(Machine Readability)」を兼ね備えた設計思想への転換が急務となっています。
制作会社やコンサルティングファームにおいても、クライアントへの納品要件として従来の「デザインカンプ」「レスポンシブ対応」「Core Web Vitals」に加え、「AIOアンサーターゲット準拠」「Schema.orgエンティティ統合」「llms.txt配置」を標準品質ガイドラインとして組み込む動きが加速しています。
8. 結論と提言:ゼロクリック検索環境下で企業が講ずべき3つの構造的アプローチ
7,803件の実測ログが示したのは、検索情報流通の競争軸として、従来のドメイン権威性やリンク規模に加え、「AIが誤解なく引用できるセマンティック基盤を確立できているか」という構造的完全性が、決定的に重要な差別化要因として浮上している現実です。
今後、ゼロクリック検索環境下でブランドの認知と引用シェアを防衛・拡大するために、企業およびWeb技術統括者は以下の3つの構造的アプローチを速やかに推進することが推奨されます。
H2/H3見出し直後に要約テキストを配置するアンサーターゲット構造を全社的コンテンツ規約として制定し、Schema.orgに基づく構造化データを単一ページだけでなくドメイン全体へ横断展開すること。
WordPressプラグインやGTM等による構造化データの重複・分裂を排除し、`@graph` 構文を用いた正規のナレッジグラフを設計すること。組織(Organization)、著者(Person)、提供価値(Service/Product)の論理関係を明確化すること。
`llms.txt` を設置してAIエージェントに対する情報提供チャネルを整備するとともに、主要AI検索エンジンにおける引用状況と技術的警告の検出を定期的にモニタリング・監査する体制を確立すること。
報道関係者・学術研究機関の皆様へ(取材およびデータ提供について)
株式会社Bennu AIO Research Labでは、本実態調査に関する詳細なクロス集計データ(業種別・ドメイン規模別の不適合比率推移等)の提供、学術研究・報道向けの統計資料提供、およびAI検索最適化(AIO/GEO)に関する取材・執筆・講演の要請を承っております。下記窓口よりお問い合わせください。
- 調査・分析主体:株式会社Bennu AIO Research Lab
- 調査手法:次世代検索適合性診断プラットフォーム「AIOGeoScan」におけるDOM解析およびセマンティックログ集計
- 標本サイズ:2026年8月期 有効個別ページ診断 7,803件(累計診断ログ 11,839件)
- データ収集期間:2026年8月1日 〜 2026年8月31日
- 引用・転載規定:本調査の内容、グラフ、数値を報道・論文・資料等に引用・転載する際は、必ず「AIOGeoScan Research調べ(https://aiogeoscan.com/)」と出所を明記してください。